NET 논문 소개

- 처음으로
- >
- NET 논문 소개
● 제목 : Enhanced learning for nuclear power plant condition diagnoses using information metric based on Bayesian neural networks and UMAP
● 저자 : Young Ho Chae(KAERI), Seo Ryong Koo(KAERI), Jeonghun Choi(KAERI), Jonghyun Kim(KAIST)
- □ 원자력발전소의 상태진단에 인공지능을 적용하려는 시도는 빠르게 늘고 있으나, 안전이 최우선인 원전 환경에서는 두 가지 근본적인 제약이 따른다. 첫째, 대부분의 심층학습 모델은 예측의 불확실성을 정량화하지 않은 채 결정론적인 답만 내놓기 때문에, 운전원이 그 답을 어느 정도 신뢰해야 하는지 판단할 근거가 없다. 둘째, 비정상 상태의 라벨 데이터는 본질적으로 희소하다. 실제 원전에서 비정상 사건은 드물게 발생하며, 시뮬레이터로 생성하더라도 시나리오마다 전문가의 검토와 라벨링이 필요하다.
- □ 베이지안 신경망(Bayesian neural network, BNN)은 가중치를 하나의 값이 아니라 확률분포로 학습함으로써 데이터 자체의 노이즈(우연적 불확실성)와 모델 지식의 한계(인식적 불확실성)를 함께 표현한다. 즉 모델이 "무엇을 모르는지"를 스스로 드러낼 수 있어, 위험정보 기반 의사결정을 지향하는 원전 운영과 잘 맞는다.
- □ 능동학습(active learning)은 모든 데이터가 같은 가치를 갖지 않는다는 전제에서 출발하여, 모델 개선에 가장 유용한 표본만 골라 라벨을 획득하는 학습 방식이다. 그러나 기존의 능동학습은 대개 예측 불확실성이라는 단일 기준에 의존하기 때문에, 이상치나 노이즈가 큰 표본을 고르거나 특징 공간의 일부 영역만 반복해서 선택하는 한계가 있다.
- □ 본 논문은 BNN의 불확실성 정보와 UMAP(Uniform Manifold Approximation and Projection) 임베딩 공간의 밀도 정보를 결합한 다중 요소 "정보 필요도(information need)" 지표를 제안하고, 이 지표로 학습 표본을 단계적으로 선택하는 능동학습 프레임워크를 개발하여 IAEA iPWR 시뮬레이터의 26가지 비정상 상태 진단 문제에 적용하였다.
- □ 진단 모델은 116개 계통 변수의 시계열 창(window)을 입력받아 비정상 상태의 유형을 분류하는 BNN-LSTM이다. 가중치 분포의 평균과 로그분산을 각각 학습하는 두 개의 병렬 LSTM(2층, 층당 32개 은닉 유닛)과 베이지안 완전연결 출력층으로 구성되며, 재매개변수화 기법으로 가중치를 표본추출하여 같은 입력에 대해 서로 다른 예측을 생성함으로써 인식적 불확실성을 포착한다. 손실함수는 교차엔트로피와 KL 발산의 합으로 정의하였다.
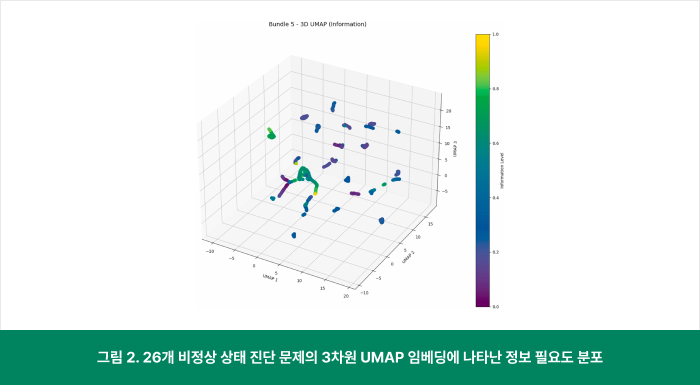
- □ 고차원의 센서 데이터와 은닉층 표현은 UMAP으로 2~3차원 공간에 임베딩하였다. UMAP은 t-SNE와 달리 국소 구조와 전역 구조를 함께 보존하고 계산 복잡도가 O(N log N)으로 낮아, 임베딩을 반복 계산해야 하는 능동학습 과정에 적합하다. 임베딩 공간은 데이터 분포와 정보 필요도를 시각화하는 창이자, 밀도 계산의 기반으로 활용된다.
2. 다중 요소 정보 필요도 지표와 점진적 학습
- □ 정보 필요도 I(x)는 네 가지 요소의 가중합으로 정의된다. 상위 두 클래스의 확률 차와 나머지 확률질량의 분포를 함께 고려한 마진 기반 불확실성 U(x), UMAP 공간에서 커널밀도추정으로 얻는 밀도 D(x)(희소한 영역일수록 높은 점수), 예측분포의 엔트로피 E(x), 그리고 이미 선택된 표본들의 중심으로부터의 거리로 정의한 다양성 Div(x)이다. 가중치는 학습 주기에 따라 규칙 기반으로 조정하여, 초기에는 밀도와 다양성(탐색)을, 후기에는 불확실성과 엔트로피(결정경계의 정교화)를 강조하도록 하였다.
-
□
점진적 학습은 모든 방법이 동일한 120개의 초기 표본에서 출발하여,
매 주기마다 미라벨 풀에서 120개씩을 각 전략에 따라 선택·추가하면서
총 5주기(720개)까지 모델을 미세조정하는 방식으로 설계하였다.
비교 대상은 제안 지표(HI), 최신의 불확실성 기반 능동학습인 BALD, 그리고 무작위 선택(RS)이다.
- □ IAEA의 iPWR 소형모듈원자로 시뮬레이터에서 급수계통, 자동감압계통, 잔열제거계통, 증기발생기, 주증기계통, 진공 상실 등 26가지 비정상 시나리오를 각각 30가지 심각도로 모의하여 780개의 시나리오 사례(116개 변수, 20초 슬라이딩 창)를 생성하였고, 시나리오 사례 단위로 80/20 분할하여 학습·평가하였다. 본 실험에서는 최대 5 %의 가우시안 노이즈를 더하여 계측 불확실성을 모사하였다.
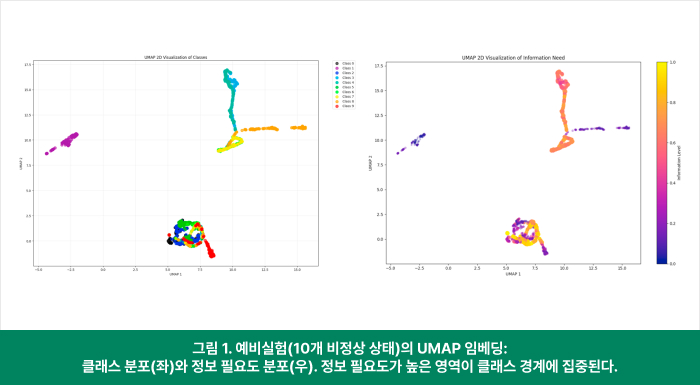
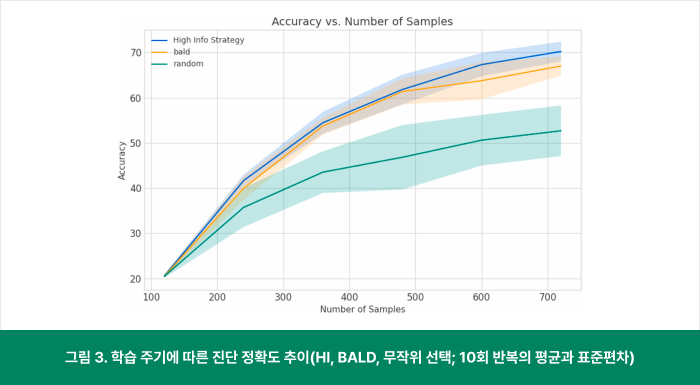
- □ 먼저 증기발생기·주증기·복수기 관련 10개 시나리오로 예비실험을 10회 반복한 결과, 학습 데이터를 5 %에서 12.5 %까지 늘리는 동안 HI 전략은 무작위 선택보다 일관되게 높은 정확도를 보였다 (7.5 %에서 78.51 % 대 70.81 %, 12.5 %에서 83.45 % 대 78.92 %). 특히 첫 주기의 정확도 향상 폭이 11.24 %p로 무작위 선택(3.54 %p)의 약 3.2배에 달하여, 라벨 데이터가 가장 부족한 초기 단계에서 효과가 가장 컸다.
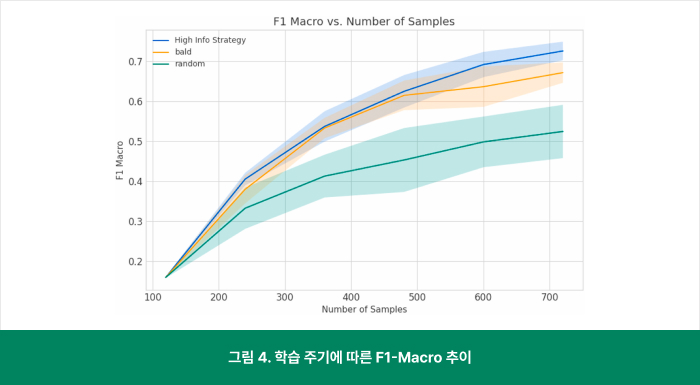
- □ 26개 클래스 본 실험(10회 반복)에서는 720개 표본 기준으로 HI 70.24 ± 2.18 %, BALD 67.03 ± 2.12 %, 무작위 선택 52.68 ± 5.62 %의 정확도를 얻었다. HI는 3주기(480개)만으로 무작위 선택의 최종 성능을 넘어섰으므로 동등한 성능에 필요한 라벨 수를 약 50 % 줄인 셈이며, BALD 대비로도 약 17 % 적은 표본으로 같은 성능에 도달하였다. F1-Macro 0.726(BALD 0.672)과 AUC-Macro 0.974는 성능 향상이 일부 쉬운 클래스에 편중되지 않고 26개 클래스 전반에 걸쳐 균형 있게 얻어졌음을 보여 주며, 학습이 진행될수록 HI의 표준편차는 감소한 반면 무작위 선택의 편차는 오히려 증가하였다.
- □ UMAP 시각화는 이러한 결과의 원인을 설명해 준다. 정보 필요도가 높은 영역은 클래스 간 경계와 데이터가 희소한 영역에 집중되어 있었고, 클래스 군집의 중심부에서 경계부로 갈수록 정보 필요도가 매끄럽게 증가하는 경사가 관찰되었다. 즉 제안 지표는 모델이 아직 잘 구분하지 못하는 경계 표본과 대표성이 부족한 표본을 정확히 골라내고 있었다.
-
□
알고리즘 검증 수행 시 내장 모듈을 활용하여 평가하는데 소요되는 시간을 비교하였다.
개발 알고리즘은 Moving Window 기법을 통해 평균 86.24%의 평가시간 감소를 달성하였다.
- □ 본 연구는 베이지안 신경망의 불확실성과 UMAP 임베딩 공간의 밀도·다양성을 하나의 정보 필요도 지표로 통합하고, 이 지표에 기반한 점진적 능동학습이 원전 비정상 상태 진단의 정확도, 안정성, 데이터 효율을 동시에 높일 수 있음을 보였다.
- □ 제안 방법은 26개 비정상 상태에 대해 70.24 %의 정확도로 BALD와 무작위 선택을 능가하였고, 동일한 성능에 필요한 라벨 데이터를 무작위 선택 대비 50 % 절감하였다. 정보 필요도의 시각화는 어떤 표본이 왜 필요한지를 개발자와 운전원이 확인할 수 있는 근거를 제공한다.
- □ 한편 규칙 기반 가중치의 최적화, UMAP 계산 부담의 경감, 경계 영역 편중의 완화, 센서 고장·열화 등 실제 계측 조건의 반영은 후속 연구 과제로 남아 있다. 라벨 데이터가 희소하고 높은 신뢰성이 요구되는 원전 상태진단에서, 본 프레임워크는 "무엇을 더 배워야 하는지"를 모델 스스로 알려 주는 실용적인 도구가 될 것으로 기대된다.